
Introducción
Hace ya unos años que Microsoft incorporó a DAX una nueva familia de funciones tabulares muy especiales: las funciones WINDOW. Se trata de funciones conceptualmente muy similares a las funciones homónimas de SQL, diseñadas para operar sobre conjuntos de datos previamente ordenados y, si es necesario, particionados.
Hasta ese momento, resolver cálculos dependientes de posiciones relativas; el primer cliente, el anterior pedido, el siguiente valor en un ranking, implicaba recurrir a funciones como TOPN o RANKX, y a iteraciones anidadas.
Estas funciones no amplían realmente la capacidad expresiva de DAX, todo lo que hoy hacemos con estas funciones ya podía hacerse antes, pero sí transforman la forma en que lo escribimos. Simplifican el código, lo hacen más mantenible y, en muchos casos, más eficiente. Además, introducen un concepto nuevo y fundamental en el lenguaje: apply semantics, al que seguramente dedicaremos otro artículo más adelante, que permite que dichas funciones interactúen simultáneamente con el contexto de fila y el contexto de filtro.
En este artículo vamos a aplicar estas funciones a un caso de negocio muy habitual: la identificación de clientes nuevos, perdidos y recuperados. Un problema clásico en análisis comercial que, gracias a estas funciones puede resolverse hoy con un rendimiento, claridad y precisión muy superiores a los patrones tradicionales.
Aunque el foco estará en clientes, el patrón que construiremos es completamente generalizable. La misma lógica puede aplicarse para detectar productos que dejan de venderse, productos reactivados, tiendas que inician o cesan actividad, comerciales que recuperan cartera…
En los siguientes apartados veremos cómo funcionan estas funciones y cómo utilizarlas correctamente para construir un patrón sólido, reutilizable y eficiente.
Entendiendo las funciones WINDOW en DAX
Vamos a iniciar nuestra andadura con las funciones WINDOW y a centrarnos en las más importantes y las que primero se introdujeron: INDEX, OFFSET y WINDOW.
Son funciones tabulares, es decir, nos devuelven una tabla, igual que FILTER, VALUES o ADDCOLUMNS. Su propósito es muy concreto: navegar sobre una tabla ordenada y particionada, es decir, dividida en bloques de filas, para extraer la fila o las filas que nos interesan.
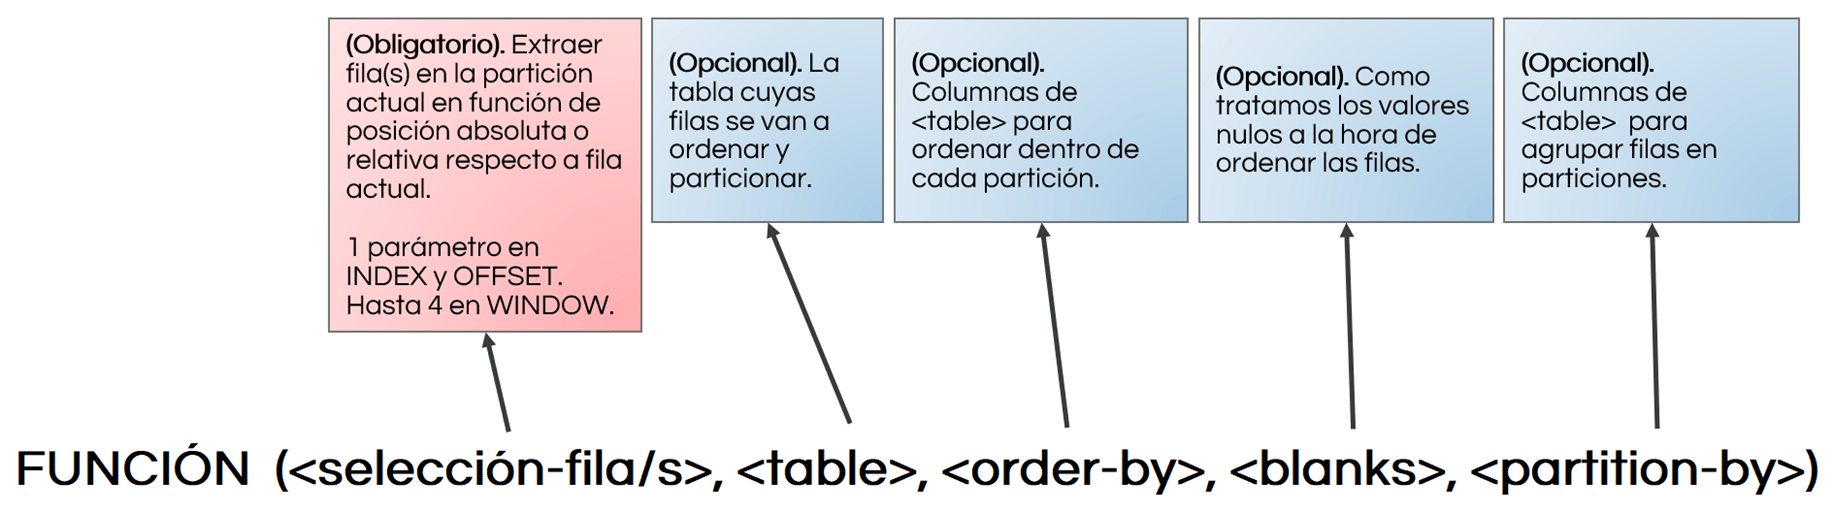
Una característica diferencial es que la mayoría de sus argumentos son opcionales y están diseñadas para poder indicarlos en cualquier orden. Si nos fijamos en la sintaxis (ver imagen), las tres funciones comparten la misma estructura y funcionan siguiendo siempre el mismo proceso:
- Toman todas las filas de la tabla que indiquemos en el parámetro
<table>. Esta será la tabla fuente. - Dividen esas filas en particiones según las columnas indicadas en
<partition-by>. - Ordenan las filas dentro de cada partición según las columnas de
<order-by>. - Y finalmente, con el primer parámetro (el único obligatorio) decidimos qué fila o filas queremos devolver.
Pulsar en la imagen para agrandar
Como vemos en la imagen, tenemos además otro parámetro opcional, <blanks>, que permite indicar cómo tratar los valores nulos al ordenar. De momento no entraremos en detalle en este y otros parámetros opcionales que vinieron después, porque suficiente complejidad tienen ya estas funciones.
La diferencia real entre las tres funciones está en el primer parámetro.
- INDEX solo puede devolver una fila, y lo hace indicando la posición absoluta dentro de la partición: primera fila, segunda fila, última fila…
- OFFSET también devuelve una única fila, pero la posición se especifica de forma relativa respecto a la fila actual: una fila anterior, tres filas antes, la siguiente fila…
- WINDOW va un paso más allá y permite devolver un conjunto de filas, definiendo el límite inferior y superior de la ventana. Esos límites pueden indicarse tanto en valor absoluto (como INDEX) como en valor relativo (como OFFSET).
Podemos ver un resumen en la siguiente imagen:

Consideraciones respecto al rendimiento
Aunque en general el rendimiento de estas funciones es muy bueno, especialmente cuando necesitamos ordenar por varias columnas con valores discontinuos, conviene tener en cuenta algunos aspectos para no llevarnos una sorpresa, y no olvidar que, como siempre en DAX, cuando trabajamos con modelos exigentes medir el rendimiento de distintas alternativas es parte del trabajo.
La razón por la cual el rendimiento de estas funciones suele ser excelente, es porque nos permiten trabajar sobre valores ya agregados, y no sobre la tabla de hechos a su máxima granularidad.
Para quienes conozcan la diferencia entre el Formula Engine y el Storage Engine, el punto clave es que las funciones WINDOW se ejecutan íntegramente en el Formula Engine.
Esto implica que el Formula Engine necesita una copia completa de las filas (y columnas) de la tabla que pasamos como parámetro <table>. Incluso en modelos import, no reutiliza directamente la estructura interna de VertiPaq, sino que crea sus propias estructuras en memoria (spools) para:
- almacenar los datos de la tabla base,
- mapear las particiones,
- mantener arrays ordenados dentro de cada partición,
- y vincular la fila actual del contexto con su posición en esas estructuras.
Cuantas más filas y más columnas tenga la tabla de entrada, mayor será el consumo de memoria y el trabajo del Formula Engine.
Por eso, en mi opinión, estas funciones son especialmente útiles cuando la granularidad del cálculo está bien definida y no va a ser modificada dinámicamente por el usuario en la visualización.
En escenarios donde el usuario puede cambiar la granularidad, hay que ser prudente. Diseñar un patrón con WINDOW que funcione correctamente para cualquier nivel de granularidad puede disparar el número de filas que el Formula Engine necesita materializar, y el impacto en el rendimiento puede ser notable.
Por último, si trabajamos en modo DirectQuery, las funciones WINDOW pueden ayudar significativamente, ya que es mucho más probable que las queries generadas por el motor utilicen las tablas de agregaciones que hayamos definido. Precisamente por la misma razón que comentábamos antes: porque nos permiten trabajar sobre valores ya agregados, en lugar de forzar cálculos a la máxima granularidad.
Modelando el ciclo de vida del cliente en DAX
Antes de meternos en arena, conviene detenerse en lo esencial: este tipo de cálculos depende completamente de las reglas de negocio que definan qué entendemos por cliente nuevo, perdido o recuperado. La lógica técnica es solo una traducción formal de esa definición. Si la definición cambia, el cálculo cambia.
Vamos a comenzar por los clientes nuevos, cuya interpretación suele ser bastante homogénea en la mayoría de organizaciones: consideraremos cliente nuevo a aquel que realiza una transacción por primera vez, sin haber registrado ninguna operación en ningún momento anterior a esa fecha. Es decir, su aparición marca el inicio absoluto de su relación comercial con la empresa. Si la granularidad temporal del cálculo es anual, la fórmula a implementar sería la siguiente:
Clientes Nuevos =

VAR _PeriodoActual =
    SELECTEDVALUE ( Calendario[Año] )
VAR _ClientesPeriodoActual =
    CALCULATETABLE (
        SUMMARIZE (
            ALLSELECTED ( EntradaHoras ),
            Clientes[NombreComercial]
        ),
        Calendario[Año] = _PeriodoActual
    )
VAR _ClientesYaExistentes =
    CALCULATETABLE (
        SUMMARIZE (
            ALLSELECTED ( EntradaHoras ),
            Clientes[NombreComercial]
        ),
        WINDOW (
            0,
            ABS,
            -1,
            REL,
            SUMMARIZE (
                ALLSELECTED ( EntradaHoras ),
                Calendario[Año]
            ),
            ORDERBY ( Calendario[Año], ASC )
        )
    )
VAR _ClientesNuevos =
    EXCEPT (
        _ClientesPeriodoActual,
        _ClientesYaExistentes
    )
VAR _NumClientesNuevos =
    COUNTROWS ( _ClientesNuevos )

RETURN
_NumClientesNuevosEsta medida calcula los clientes que aparecen por primera vez en el año seleccionado en el contexto de filtro. Para ello, primero obtiene los clientes con actividad en dicho año y después, utilizando WINDOW, construye el conjunto de clientes que tuvieron actividad en cualquier año anterior. Finalmente, mediante EXCEPT, se queda únicamente con los que están en el periodo actual pero no existían antes, y los cuenta con COUNTROWS.
En el caso de los clientes perdidos, si consideramos que estos son aquellos que no han tenido actividad en el año visible en el contexto de filtro actual, pero si en el año inmediatamente anterior, deberemos calcular estas dos variables:
VAR _ClientesPeriodoAnterior =
    CALCULATETABLE (
        SUMMARIZE (
            ALLSELECTED ( EntradaHoras ),
            Clientes[NombreComercial]
        ),
        WINDOW (
            -1,
            REL,
            -1,
            REL,
            SUMMARIZE (
                ALLSELECTED ( EntradaHoras ),
                Calendario[Año]
            ),
            ORDERBY ( Calendario[Año], ASC )
        )
    )
VAR _ClientesPerdidos =
    EXCEPT (
        _ClientesPeriodoAnterior,
        _ClientesPeriodoActual
)En este caso, la lógica es simplemente la inversa. _ClientesPeriodoAnterior obtiene, mediante WINDOW, los clientes que tuvieron actividad exclusivamente en el año inmediatamente anterior al visible en el contexto. La ventana -1, REL, -1, REL delimita precisamente ese único periodo previo.
Después, EXCEPT elimina de ese conjunto los clientes que sí aparecen en el periodo actual. El resultado son aquellos que estaban activos el año pasado y ya no lo están en el actual.
Por último, para los clientes recuperados, si entendemos estos como aquellos que han tenido actividad en el periodo seleccionado, no la tuvieron el año anterior, pero si en periodos anteriores a este, haremos lo siguiente:
VAR _ClientesYaExistentes =
    CALCULATETABLE (
        SUMMARIZE (
            ALLSELECTED ( EntradaHoras ),
            Clientes[NombreComercial]
        ),
        WINDOW (
            0,
            ABS,
            -2,
            REL,
            SUMMARIZE (
                ALLSELECTED ( EntradaHoras ),
                Calendario[Año]
            ),
            ORDERBY ( Calendario[Año], ASC )
        )
    )
VAR _ClientesNuevos =
    EXCEPT (
        _ClientesPeriodoActual,
        _ClientesPeriodoAnterior
    )
VAR _ClientesRecuperados =
    INTERSECT (
        _ClientesNuevos,
        _ClientesYaExistentes
)Para este cálculo combinamos dos condiciones complementarias. Por un lado, identificamos los clientes que están activos en el periodo actual pero no en el anterior (_ClientesNuevos). Por otro, mediante WINDOW, obtenemos aquellos que tuvieron actividad en algún periodo previo distinto del inmediatamente anterior (_ClientesYaExistentes).
La intersección de ambos conjuntos (INTERSECT) nos devuelve exactamente los clientes que han vuelto tras un periodo de inactividad. De nuevo, todo se resuelve comparando conjuntos temporales bien delimitados con la función WINDOW.
Conviene señalar que este patrón no se limita a devolver un recuento de clientes. Al trabajar con tablas intermedias que contienen explícitamente los conjuntos resultantes, podemos también recuperar el detalle de los clientes que cumplen cada condición.
Por ejemplo, en el caso de los clientes nuevos, bastaría con concatenar los nombres contenidos en la tabla _ClientesNuevos:
VAR _ClientesNuevosNombre =
    CONCATENATEX (
        _ClientesNuevos,
        Clientes[NombreComercial],
        ", "
)De esta forma podemos mostrar la evolución temporal de las tres métricas; nuevos, perdidos y recuperados, en una visualización, y al mismo tiempo ofrecer el detalle de los nombres en un tooltip:
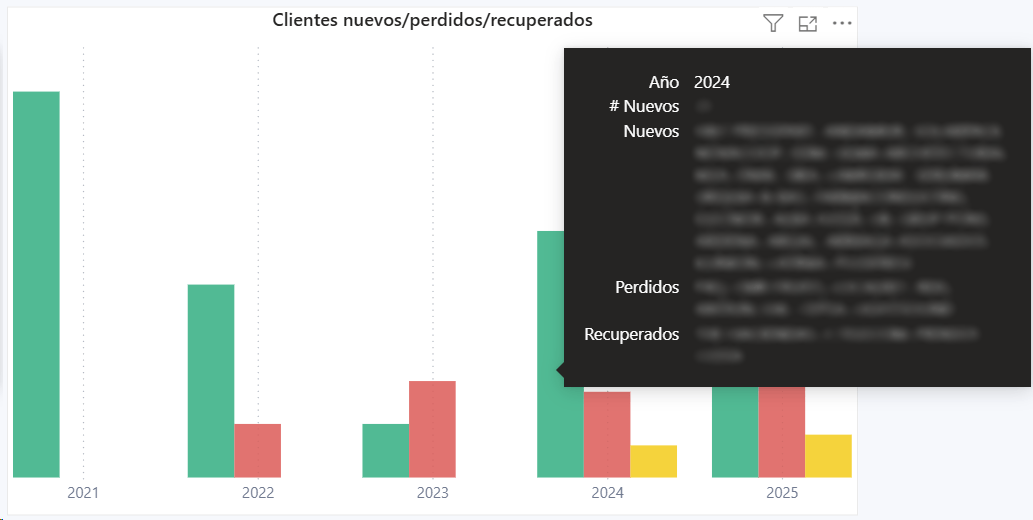
Una ventaja adicional de este patrón es que funciona correctamente bajo cualquier contexto de filtro definido por el usuario. Esto significa que podemos analizar clientes nuevos, perdidos o recuperados no solo a nivel global, sino también para un departamento concreto, un empleado, una tienda o cualquier combinación de atributos dimensionales del modelo de datos.
Conclusión
Las funciones WINDOW aportan una forma más clara de resolver ciertos patrones que antes requerían lógica más compleja y, en el escenario adecuado, pueden ofrecer un rendimiento extremadamente bueno. No hacen posible nada que no pudiera hacerse antes en DAX, pero permiten escribirlo de una manera más directa, estructurada y mantenible.
El ejemplo de clientes nuevos, perdidos y recuperados es solo una aplicación práctica. El mismo planteamiento puede utilizarse para comparar estados, detectar cambios o analizar posiciones relativas dentro de cualquier conjunto ordenado, no necesariamente temporal.
Como ocurre siempre en DAX, el resultado depende menos de la función y más del diseño del modelo: definir bien las reglas de negocio, trabajar a la granularidad adecuada y validar el rendimiento cuando el modelo lo exige. Cuando esas piezas están bien resueltas, las funciones WINDOW encajan de forma natural y simplifican notablemente el desarrollo de cálculos complejos.


Deja un comentario